
DPDT 기반 생성형 AI 프롬프트 창의성 정량화 시스템 설계

Copyright © 2026 Korean Institute of Broadcast and Media Engineers. All rights reserved.
“This is an Open-Access article distributed under the terms of the Creative Commons BY-NC-ND (http://creativecommons.org/licenses/by-nc-nd/3.0) which permits unrestricted non-commercial use, distribution, and reproduction in any medium, provided the original work is properly cited and not altered.”
초록
생성형 AI 활용이 확대되면서 프롬프트에 나타나는 인간의 창작적 개입을 정량적으로 분석할 필요성이 제기되고 있다. 본 연구는 이중 경로 확산적 사고(Dual Pathway Divergent Thinking, DPDT) 이론을 바탕으로 생성형 AI 프롬프트의 창의성 관련 특성을 정량화하는 시스템을 제안한다. DPDT의 유연성(Flexibility)과 지속성(Persistence) 개념을 프롬프트에서 관찰 가능한 특성으로 조작화하고, 이를 복수의 세부 지표로 구성하여 통제된 프롬프트 조건에서 지표의 반응 양상을 검증하였다. 분석 결과, 제안 지표는 프롬프트의 특성 변화에 따라 서로 다른 반응 양상을 나타냈으며, 유연성 및 지속성 관련 점수가 종합 점수에 의도한 방향으로 반영됨을 확인하였다. 본 연구는 인간의 창의성 자체를 직접 측정하기보다, 생성형 AI 창작 과정에서 프롬프트에 나타나는 창의성 관련 특성을 구조화하고 정량적으로 기록·분석하기 위한 보조적 기술 기반을 제안한다.
Abstract
As the use of generative AI expands, there is a growing need to quantitatively analyze human creative intervention in prompts. Based on the Dual Pathway Divergent Thinking (DPDT) theory, this study proposes a system to quantify creativity-related characteristics of generative AI prompts. We operationalized the DPDT concepts of “Flexibility” and “Persistence” as observable characteristics in prompts, structured them into multiple detailed indicators, and verified the response patterns of these indicators under controlled prompt conditions. The analysis revealed that the proposed indicators exhibited different response patterns depending on changes in prompt characteristics, and confirmed that scores related to flexibility and persistence were reflected in the composite score as intended. Rather than directly measuring human creativity itself, this study proposes a supplementary technical framework for structuring, quantitatively recording, and analyzing creativity-related characteristics that appear in prompts during the generative AI creative process.
Keywords:
Generative AI, Prompt Analysis, Creativity Quantification, Dual Pathway Divergent ThinkingⅠ. 서 론
최근 생성형 AI 기술의 대중화와 급속한 확산은 디지털 콘텐츠 창작 생태계 전반에 구조적인 변화를 촉진하고 있다. 이러한 변화는 창작 활동의 생산성을 크게 향상시켰으나, AI 활용 산출물에서 인간의 창작적 기여 인정 정도에 대해서는 여전히 국제적인 논의가 지속되고 있다.
2025년 1월 미국 저작권청(USCO)은 현재 기술 수준에서 프롬프트만으로는 AI 생성물에 대한 충분한 인간의 통제를 인정하기 어렵다고 보면서도, 향후 프롬프트가 표현적 요소를 충분히 통제할 수 있는 수준에 이른다면 저작권 판단이 달라질 가능성을 제시하였다[1]. 중국 베이징 인터넷 법원의 Li v. Liu 판결에서는 원고가 아이디어를 구상하고 프롬프트를 반복적으로 설계·조정한 뒤 최종 결과물을 선택한 일련의 과정을 인정하여 독창성과 지적 성과의 요건을 충족하는 미술저작물에 해당한다고 판단하였다[2]. 또한 한국저작권위원회와 문화체육관광부는 순수 AI 산출물의 저작권 등록을 인정하지는 않으나, 프롬프트 입력 이후의 수정·편집 과정에서 나타난 인간의 창작적 기여는 저작물의 저작성 판단에 영향을 미친다고 제시하고 있다[3]. 이처럼 생성형 AI 환경에서는 최종 산출물뿐 아니라 창작 과정 전반에서 이루어지는 인간 개입이 중요한 논의 대상으로 부각되고 있다.
인간의 창작적 기여를 기술적으로 분석하려는 기존 접근은 크게 콘텐츠 기반(content-based) 접근과 생성 과정 기반(process-based) 접근으로 구분할 수 있다. 콘텐츠 기반 접근은 AI 생성물과 기존 저작물 간의 시각적·실질적 유사성을 분석하지만[4,5], 생성 과정에서 이루어진 인간의 개입 자체를 직접 분석하지는 않는다. 생성 과정 기반 접근은 C2PA와 같은 콘텐츠 출처 표준을 통해 생성 및 수정 이력을 검증하지만[6,7], 프롬프트에 나타나는 아이디어 탐색이나 표현적 변화를 직접 분석하지는 않는다. 즉 두 접근 모두 인간이 작성·수정한 프롬프트에 나타나는 창의성 관련 특성을 정량적으로 분석하는 데에는 한계가 있다.
생성형 AI 창작 과정에서 인간의 개입을 분석하기 위해서는 기존의 산출물 유사성이나 생성 이력 기록과 함께 프롬프트 자체에 나타나는 특성을 분석할 필요가 있다. 프롬프트는 생성 대상, 구성 요소, 표현 방식 및 수정 방향 등 사용자의 의도와 선택이 나타날 수 있는 관찰 가능한 기록이다. 그러나 프롬프트의 길이, 어휘량, 수식어 사용량 등이 곧 인간의 창의성 수준을 의미하는 것은 아니므로, 창의적 사고와 관련된 특성을 이론적으로 구분하여 분석할 필요가 있다. 이에 본 연구는 이중 경로 확산적 사고(Dual Pathway Divergent Thinking, DPDT) 이론의 유연성(Flexibility)과 지속성(Persistence) 개념을 생성형 AI 프롬프트 분석의 이론적 틀로 설정하였다.
이러한 관점에서 본 논문의 연구 질문은 다음과 같다. 첫째, DPDT의 유연성과 지속성 개념을 생성형 AI 프롬프트의 창의성 관련 특성 분석에 어떠한 방식으로 적용할 수 있는가. 둘째, 제안된 세부 지표는 통제된 프롬프트 특성의 변화에 따라 설계된 방향으로 반응하는가.
이러한 연구 질문에 답하기 위해 본 연구는 프롬프트에서 관찰 가능한 유연성 및 지속성 관련 텍스트 특성을 조작적으로 정의하여 이를 정량화하는 시스템을 설계하였다.
Ⅱ. 관련 연구
1. 생성형 AI 환경에서의 인간 창작
생성형 AI가 창작 도구로 활용되면서 인간과 AI가 공동으로 결과물을 생성하는 과정 자체를 분석하려는 인간-AI 공동 창작(Human-AI Co-creativity) 연구가 확대되고 있다. Karimi 외 3인은 co-creative system의 창의성 평가 요소를 구분하였고[8], Rezwana와 Maher는 인간-AI 공동 창작의 상호작용 구조를 분석하는 COFI를 제안하였다[9].
창의성은 오랫동안 다양한 관점에서 논의되어 왔다. Rhodes는 창의성을 창작 주체(Person), 창작 과정(Process), 창작 환경(Press), 창작 산출물(Product)의 4P로 구분하였다[10]. Amabile은 영역 관련 기술, 창의성 관련 과정, 과제 동기의 상호작용으로 설명하였고[11], Csikszentmihalyi는 개인, 영역(domain), 장(field)의 상호작용에서 성립한다고 보았다[12]. 또한 Kaufman과 Beghetto는 창의성의 수준을 Big-C, little-c, mini-c, Pro-c로 구분하는 4C 모형을 제안하였다[13]. 이러한 논의는 창의성을 하나의 관찰 변수로 단순화하기보다 서로 다른 수준과 관점에서 구분하여 이해할 필요가 있음을 보여준다.
Guilford는 창의성을 발산적 사고로 보고 주요 요소로 유창성(Fluency), 유연성(Flexibility), 독창성(Originality), 정교성(Elaboration)을 제시하였다[14]. 이러한 관점은 발산적 사고 평가에 활용되어 왔다. Olson은 확산연관과제(DAT)를 제안하였으나, 단어 목록을 중심으로 설계되었다는 점에서 현재의 프롬프트 분석 단위와는 다른 점이 있다[15]. Organisciak은 인간 채점 데이터로 언어모델을 학습해 기존의 semantic-distance 기반 자동 채점 방법보다 높은 일치도를 보이는 평가 방법을 제안하였다[16]. 그러나 해당 방법 역시 특정 질문에 대한 응답을 평가 대상으로 삼는다는 점에서, 본 연구와는 대상과 단위가 다르다. 본 연구는 유연성과 지속성이라는 두 경로를 중심으로 창의적 사고를 설명하는 이중 경로 창의성 모델과 DPDT를 바탕으로, 프롬프트에 나타나는 창의성 관련 특성을 정량적으로 분석하는 방법을 제안한다.
2. 이중 경로 창의성 모델과 DPDT
창의적 아이디어 생성 과정의 인지적 경로를 설명하기 위해 Nijstad는 이중 경로 창의성 모델(Dual Pathway to Creativity Model, DPCM)을 제안하였다[17]. 이 모델은 창의적 아이디어 생성이 서로 다른 범주와 관점을 탐색·전환하는 인지적 유연성(cognitive flexibility)과 제한된 아이디어 범위 내에서 지속적으로 탐색을 이어가는 인지적 지속성(cognitive persistence)의 두 경로를 통해 설명될 수 있다고 본다. 이후 Taylor와 Barbot은 이러한 이중 경로 관점을 창의적 글쓰기 과정에 적용하여 지속성과 노력(persistence and effort)이 창의적 글쓰기 산출과 관련될 수 있음을 제시하였다[18]. Peterson과 Pattie는 이중 경로 확산적 사고(DPDT)를 제안하고 이를 실증적으로 검토하였다[19]. 이러한 연구는 창의적 아이디어 생성 과정이 단순한 아이디어의 양만으로 설명되지 않고, 탐색 범주의 확장과 특정 방향에 대한 지속적 탐색이라는 복합적 경로를 통해 설명될 수 있음을 보여준다.
생성형 AI의 확산과 함께 프롬프트 작성 및 수정 행위 자체를 창작 과정의 관점에서 분석하는 연구도 등장하였다. Oppenlaender는 텍스트-이미지 생성에서 최종 산출물 중심의 창의성 평가만으로는 생성 과정에서 이루어지는 인간의 창작 활동을 충분히 설명하기 어렵다고 지적하고, 프롬프트가 스타일, 표현 조건, 생성 결과의 조정 등 다양한 요소로 구성될 수 있음을 보여주었다[20]. 또한 후속 연구에서도 프롬프트의 품질을 평가하고 작성·개선하는 과정을 실험적으로 분석하여, 프롬프트 엔지니어링(prompt engineering)이 학습과 연습이 필요한 창작 관련 기술임을 제시하였다[21]. 이러한 연구는 프롬프트 작성 및 수정이 생성형 AI 창작 과정에서 유의미한 인간-AI 상호작용임을 보여주지만, 프롬프트 자체를 인간의 창의성을 직접 측정하는 도구로 검증한 것은 아니다. Torricelli는 생성형 AI 플랫폼의 프롬프트 로그를 분석하여 새로운 개념을 탐색하는 양상(exploration)과 기존 개념을 활용하는 양상이 구분되어 관찰될 수 있음을 보였다[22].
기존 연구는 발산적 사고의 자동 평가와 생성형 AI 창작 과정에서의 프롬프트 상호작용의 중요성을 다루어 왔으나, DPDT의 유연성과 지속성을 생성형 AI의 문장형 프롬프트에서 관찰 가능한 텍스트 특성으로 구분하여 정량화한 사례를 확인하기 어렵다. 따라서 본 연구는 DPDT의 두 경로와 이론적으로 관련된 텍스트 특성을 복수의 세부 지표로 조작화하여 정량적으로 분석한다. 또한 기존 연구는 주로 영어 환경에서 수행되어 왔으나, 본 연구는 한국어 문장형 프롬프트를 분석 대상으로 설정하였다.
Ⅲ. 창의성 정량화 모델
1. 창의성 정량화 시스템
본 연구는 생성형 AI 창작 과정에서 사용자가 작성한 프롬프트에 나타나는 창의성 관련 특성을 정량적으로 분석하기 위하여, 이중 경로 확산적 사고(DPDT) 이론에 기반한 창의성 정량화 시스템을 설계하였다. 본 연구에서는 프롬프트에서 관찰할 수 있는 구조적·표현적·어휘적·의미적 특성을 DPDT 관점에서 비교·분석하기 위한 지표로 정의하였다.
제안 시스템은 오프라인 단계와 온라인 단계로 구성된다. 오프라인 단계에서는 사전 데이터셋을 통합·정제한 후 형태소 분석과 임베딩을 수행하고, 생성된 참조 임베딩을 기반으로 KMeans 군집화 및 카테고리 매핑을 수행하여 실시간 프롬프트 분석의 기준으로 활용할 의미 참조 공간과 클러스터 중심값(centroid)을 구축한다. 온라인 단계에서는 사용자가 입력한 프롬프트에 오프라인 단계와 일관된 전처리 및 임베딩 절차를 적용하고, 생성된 입력 임베딩을 사전에 구축된 클러스터 중심값에 할당하여 의미적 분포를 분석한다. 이를 바탕으로 유연성 및 지속성 관련 세부 지표를 산출하고, 최종적으로 프롬프트의 창의성 관련 특성을 나타내는 종합 점수를 도출한다. 그림 1은 제안 시스템의 창의성 관련 특성 정량화 과정을 나타낸 데이터 흐름도이다.
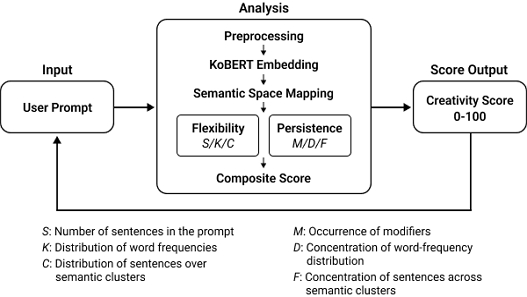
Workflow of DPDT-Based Quantification of Creativity-Related Prompt Characteristics
2. 데이터셋 구축
DPDT 기반 창의성 정량화 시스템에서 프롬프트의 의미적 특성을 분석하기 위한 참조 데이터를 구축하기 위해, 한국지능정보사회진흥원(NIA)이 운영하는 AI Hub에서 공개한 두 가지 데이터셋을 통합하여 활용하였다. 한국어 이미지 설명 데이터는 이미지 캡셔닝 및 자연어처리(NLP) 기반 모델 학습을 목적으로 구축된 공공 인공지능 학습용 데이터로[23], 이미지의 시각적 내용을 설명하는 한국어 문장을 포함한다. 본 연구의 데이터 탐색 과정에서 한국어 이미지 설명 데이터에서는 서술 중심의 문장과 비교적 제한적인 표현 및 의미 범위가 관찰되었다. 구체적으로 “~하고 있다”와 같은 정형화된 문장 패턴이 반복적으로 나타나며, 주제 영역 또한 인물·사물·행동 묘사에 상대적으로 집중되는 경향을 보였다. 이에 단일 데이터셋만을 참조 공간으로 사용할 경우 생성형 AI 프롬프트에서 나타날 수 있는 다양한 표현 특성을 충분히 포괄하기 어렵다고 판단하였다. 이러한 편중을 보완하고 참조 데이터의 의미적 다양성을 확장하기 위해, 다양한 장르와 인물·배경·연출 등의 정보를 포함하는 만화·웹툰 생성 데이터를 추가로 활용하였다[24]. 해당 데이터에 포함된 은유적·상징적·감정적 표현은 이미지 설명 데이터에서 상대적으로 제한된 장르 및 표현 특성을 보완하는 데 활용하였으며, 두 데이터셋을 통합하여 이후 의미 참조 공간 구축에 사용하였다.
통합된 데이터는 전처리 과정에서 두 단계의 중복 제거를 수행하였다. 1단계에서는 문자열 일치 여부에 기반하여 정확히 중복되는 문장을 필터링하였으며, 2단계에서는 문장 임베딩 간 코사인 유사도를 계산하여 표현은 다르지만 의미적으로 높은 유사도를 보이는 문장을 추가로 제거하였다. 이후 (1) 한글 사용 비율이 현저히 낮은 문장, (2) 문장 길이가 지나치게 짧거나 긴 문장, (3) 불필요한 기호나 의미 없는 내용이 포함된 문장을 기준으로 추가 필터링을 수행하여, 후속 임베딩 및 의미 분석에 적합한 참조 문장을 선별하였다.
정제된 문장은 형태소 분석기를 이용하여 품사 정보를 포함한 토큰 단위로 분리하였다. MeCab-ko를 기본 분석기로 사용하되[25], 사전 경로 의존성으로 인한 환경별 구동 오류에 대비하여 Okt를 보조 분석기로 병행하는 이중 구조를 적용하였다[26]. 형태소 분석 결과는 지표의 목적에 따라 서로 다른 품사 정보를 활용할 수 있도록 구성하였으며, 일반적인 어휘 특성 분석과 수식어 관련 특성 분석에 필요한 토큰을 각각 추출하였다. 이를 통해 형태소 분석 과정에서 발생할 수 있는 불필요한 토큰 및 분석 오류의 영향을 최소화하고, 이후 어휘 및 의미 기반 세부 지표 산출에 활용할 수 있는 형태로 데이터를 정제하였다.
모델 입력 단계에서는 정제된 참조 데이터를 임베딩 모델을 이용하여 의미 벡터로 변환하고, KMeans 알고리즘을 통해 임베딩 공간에서 의미적 특성이 유사한 데이터를 군집화하였다. 클러스터 수 K는 복수의 후보값에 대해 군집화를 수행하고 내부 군집 품질을 비교하여 선정하였다. 후보값 중 Silhouette Score가 가장 높게 나타난 K = 80을 최종 클러스터 수로 적용하였으며, 각 클러스터의 중심값(centroid)은 이후 입력 프롬프트의 의미 클러스터 할당 및 클러스터 분포 분석을 위한 참조값으로 저장하였다. 다만 이는 제한된 후보 범위 내에서 내부 군집 품질을 기준으로 선정한 값으로, 최적의 클러스터 수임을 의미하지는 않는다.
3. 모델 구조 및 분석 설정
유연성 관련 점수와 지속성 관련 점수는 각각 별도의 수치 지표로 산출되며, 공통된 참조 데이터와 임베딩·클러스터링 결과를 기반으로 계산된다. 두 지표는 동일한 의미 표현 및 참조 공간을 공유하되, 각 구성개념과 관련된 프롬프트 특성을 분석하기 위해 서로 다른 세부 지표를 적용한다. 이때 공통 참조 공간을 구성하는 두 데이터셋에는 동일한 필터링 및 중복 제거 기준을 적용하여 전처리 조건을 일관되게 유지하였다. 또한 산출된 세부 지표는 통합 참조 데이터의 전체 분포를 기준으로 백분위 점수(percentile score)로 정규화하여 지표 간 척도를 통일하였다.
사전학습된 언어 모델은 문장의 의미 표현을 위한 임베딩을 제공하지만 창의성 관련 점수나 의미 범주 구조를 직접 출력하지 않으므로, 임베딩 벡터에 KMeans 군집화를 적용하여 공통 의미 참조 공간을 구축하고 지표 산출에 활용하였다. 입력 문장은 형태소 분석 및 토큰화 과정을 거쳐 임베딩 벡터로 변환되며, attention mask를 고려한 mean pooling 방식을 통해 문장 단위의 고정 차원 벡터로 표현된다. 참조 데이터로부터 구축된 80개 클러스터의 중심값(centroid)을 기준으로 입력 프롬프트의 임베딩을 각 의미 클러스터에 할당하고, 프롬프트 내 입력 단위의 클러스터 분포를 기반으로 의미 범주가 다양하게 분산되는 정도와 특정 클러스터 범주에 집중되는 정도를 산출하였다. 이러한 분포 특성은 각각 유연성의 의미 클러스터 분포 기반 지표와 지속성의 의미 범주 집중도 지표에 활용하였다. 본 시스템은 정답 라벨을 기반으로 하는 지도학습 절차를 거치지 않으며, 사전학습된 언어 모델의 가중치는 고정하여 사용하였다. 데이터 기반으로 수행되는 모델 구성 과정은 참조 데이터의 의미 공간을 구축하기 위한 KMeans 군집화에 한정되며, 별도의 손실함수나 최적화 알고리즘은 적용하지 않았다. 최종적으로 각 세부 지표를 백분위 점수로 변환한 후 유연성 관련 점수와 지속성 관련 점수를 산출하고, 두 점수를 결합하여 프롬프트의 창의성 관련 특성을 나타내는 종합 점수를 도출하였다.
본 연구에서 정의한 세부 지표는 프롬프트에 나타나는 구조적·표현적·어휘적·의미적 특성을 관찰하기 위한 지표이며, 구체적인 역할과 입력 특성에 따른 반응 양상은 4장에서 검증한다.
수식 (1)은 유연성 관련 점수의 계산식을 나타낸다. 유연성 관련 점수는 구조적 확장성을 나타내는 , 어휘 다양성을 나타내는 , 의미 범주 분포를 반영하는 클러스터링 기반 지표 의 가중평균으로 계산된다.
| (1) |
수식 (2)는 지속성 관련 점수의 계산식을 나타낸다. 지속성 관련 점수는 표현적 구체화를 나타내는 , 어휘 집중도를 나타내는 , 의미 범주 집중도를 나타내는 의 가중평균으로 계산된다. 각 세부 지표의 산출 기준은 표 1과 같다.
| (2) |

Calculation Basis of Flexibility and Persistence Sub-indicators
본 연구에서 정의한 세부 지표는 선행 연구에서 다루어진 바 없는 개념이므로, 가중치에 대한 이론적·경험적 준거가 존재하지 않는다. 이에 특정 지표에 근거 없이 차등적인 중요도를 부여하는 것을 피하기 위해, 유연성과 지속성의 각 세부 지표에 동일 가중치를 적용하였다. 유연성 관련 점수에서는 로, 지속성 관련 점수에서는 로 설정하였다.
수식 (3)은 창의성 관련 종합 점수의 계산식을 나타낸다. 어느 한 경로에 우선순위를 두지 않는 초기 설정으로 두 경로에 각각 0.5의 동일 가중치를 두어 계산하였다. 표 2는 창의성 정량화 시스템에 적용된 사전학습 모델, 클러스터링 기법 및 주요 설정값을 나타낸다.
| (3) |
System Configuration and Settings
Ⅳ. 제안 지표의 반응성 검증
1. 검증 목적 및 방법론
본 장에서는 3장에서 제안한 유연성(Flexibility) 및 지속성(Persistence)의 세부 지표와 창의성(Creativity) 관련 종합 점수를 대상으로 지표 반응성 검증을 수행하였다. 이는 외부 준거에 대한 정량적 정확도(accuracy)를 평가하는 것이 아니라, 각 지표가 설계 의도에 따라 서로 다른 프롬프트 특성의 변화에 예상된 방향으로 반응하는지를 확인하는 것이 목적이다. 이를 위해 검증 대상이 되는 특성을 제외한 나머지 조건을 가능한 한 통제한 상태에서 문장 구조, 어휘 및 의미 분포, 표현적 구체화, 반복·확장 정도 등의 특정 특성을 단계적으로 조절한 통제 프롬프트를 구성하고 각 지표의 변화 양상을 비교하였다. 이때 세부 지표의 단독 증감을 해당 구성개념의 변화로 해석하지 않고, 복수 지표의 반응을 종합하여 유연성 및 지속성 관련 특성을 분석하였다. 창의성 관련 종합 점수는 앞서 산출된 유연성과 지속성을 결합하여 계산되므로, 개별 경로에 대한 검증 이후 두 경로의 변화가 최종 점수에 어떻게 반영되는지를 확인하는 통합 검증을 수행하였다.
2. 유연성 지표 검증
유연성은 서로 다른 의미 범주를 탐색하고 아이디어의 방향을 전환하는 특성이 프롬프트에 어떻게 나타나는지를 정량적으로 반영하는 지표로 설정하였다. 이를 위해 구조적 확장성을 나타내는 문장 단위 지표(S), 어휘 다양성을 나타내는 키워드 단위 지표(K), 의미 범주 분포를 반영하는 클러스터링 기반 지표(C)를 산출하였다. 그러나 각 세부 지표는 입력의 양적·구성적 특성에 따라 서로 다른 영향을 받을 수 있다. 예를 들어 새로운 의미 범주의 탐색이 없는 경우에도 문장 수, 어휘 분포 및 의미 클러스터 분포와 관련된 계산 특성에 따라 S, K, C 지표가 서로 다른 반응을 나타낼 수 있다. 따라서 본 연구에서는 개별 지표의 값뿐 아니라 세 지표의 종합적인 반응 양상을 함께 검토하였다.
단순한 입력량 증가와 의미적·어휘적 확장에 따른 반응 차이를 확인하기 위해, 세부 지표의 종합적 반응을 먼저 검증하고, 반복 입력에 따른 유연성 관련 점수의 과대 산출 가능성을 보정하기 위한 반복 패널티를 적용한 후, 각 세부 지표가 서로 다른 프롬프트 특성의 변화에 어떠한 반응 양상을 나타내는지를 추가로 확인하였다.
유연성 관련 세부 지표가 입력 특성의 변화에 따라 어떠한 반응 양상을 보이는지 확인하기 위해 수식 (1)의 계산 방법을 적용하였다. 문장 수와 어휘·의미적 구성에 차이를 둔 세 가지 프롬프트 세트인 Low Diversity(단조로운 입력, LOW), High Diversity(다양한 입력, HIGH), Repetitive Input(동일 문장의 반복을 통해 문장 수만 증가시킨 입력, MANY_SENT)을 구성하고, 각 조건에서 S, K, C 지표 및 종합 유연성 관련 점수를 산출하였다. 표 3은 각 조건에서의 세부 지표 및 유연성 관련 점수의 산출 결과를 나타낸다.
Flexibility Comprehensive Tendency Test Results
문장 수를 늘리고 어휘 및 의미 범주가 보다 다양하도록 구성한 HIGH 조건에서는 LOW 조건에 비해 S, K, C 지표가 모두 상승하였으며, 유연성 관련 점수 역시 25.54에서 50.50으로 증가하였다. 동일한 문장을 반복하여 입력한 MANY_SENT 조건에서는 S 지표가 63.21로 증가하고 K 지표는 20.00으로 낮게 유지되었으나, C 지표는 77.96으로 높은 값을 나타냈다. 그 결과 MANY_SENT 조건의 유연성 관련 점수는 53.73으로 HIGH 조건보다 높게 산출되었다. 그러나 MANY_SENT 조건은 새로운 의미 범주의 탐색이나 전환 없이 동일한 내용을 반복한 입력이며, 특히 C 지표는 클러스터 분포뿐 아니라 입력 단위 수에 따른 보정의 영향을 함께 받으므로, 반복 입력에서 나타난 C 지표의 상승을 의미적 다양성의 증가로 해석할 수 없다. 이러한 결과는 개별 세부 지표와 이들을 종합한 점수만으로는 반복에 따른 양적 증가의 영향을 충분히 구분하기 어렵다는 점을 보여준다.
앞선 결과에서 확인된 단순 반복에 따른 유연성 관련 점수의 과대 산출 가능성을 보정하기 위해, 수식 (4)와 같이 반복 패널티(repetition penalty) R을 유연성 관련 점수에 적용하였다. 여기서 Flexibilitypost는 반복 패널티 적용 후 점수, Flexibilitypre는 반복 패널티 적용 전 점수를 의미한다.
| (4) |
반복 패널티 R은 전체 문장 수 대비 고유 문장 수의 비율을 기준으로 산출하며, 동일 문장의 반복 정도가 증가할수록 값이 감소하도록 설계하였다. 패널티 적용 방식에 따른 영향을 비교하기 위해 Token 단위, Sentence 단위 및 두 방식을 결합한 Hybrid 방식을 적용하였으며, 결과는 표 4와 같다.
Comparison of Repetition Penalty Strategies
Token 단위 패널티는 동일 문장을 반복한 MANY_SENT 조건의 점수뿐 아니라, 문장 단위의 반복은 없으나 어휘 다양성이 낮은 LOW 조건의 점수도 크게 감소시켰다. LOW 조건의 어휘적 단조성은 이미 K 지표의 낮은 값으로 반영되고 있으므로, 추가적인 감점은 동일한 어휘 반복 특성을 중복하여 반영할 가능성이 있다. 이 방식은 동일 문장의 반복과 제한된 어휘의 반복을 모두 감점 대상으로 처리하여, 본 연구에서 보정하고자 하는 문장 단위 반복을 선택적으로 구분하기 어렵다는 것을 보여준다.
반면 Sentence 단위 패널티는 LOW와 HIGH 조건의 점수를 유지하면서, 동일 문장이 반복된 MANY_SENT 조건의 점수는 패널티 적용 전 53.73에서 적용 후 8.06으로 감소시켰다. Hybrid 패널티는 MANY_SENT 조건의 반복을 보정하였으나 LOW 조건에서도 Token 단위 패널티와 같은 방식의 감점이 발생하였다. 따라서 본 통제 조건에서 동일 문장의 반복에 따른 유연성 관련 점수의 상승을 선택적으로 보정한 Sentence 단위 반복 패널티를 최종 방식으로 채택하였다.
반복 패널티 R은 수식 (4)에 따라 세부 지표의 산출 방식을 변경하지 않고 유연성 관련 점수 산출 후 사후적으로 적용되는 보정 계수이다. 따라서 S, K, C 지표의 산출 결과는 유지되며 동일 문장 반복에 따른 점수의 과대 산출 가능성을 완화하도록 설계하였다.
표 5는 유연성의 세부 지표(S, K, C)가 서로 다른 프롬프트 특성의 변화에 어떠한 반응 양상을 보이는지를 확인하기 위한 통제 실험 결과를 나타낸다. 각 검증별로 기준 조건(reference)을 설정하고 검증 대상 특성을 중심으로 입력 조건을 조절하여 나머지 조건의 변화는 가능한 한 최소화하였다. Sentence 검증(S)에서는 동일 문장의 반복 횟수를 변화시켜 문장 단위의 구조적 변화를 조절하였고, Lexical 검증(K)에서는 공통된 주제 범위 내에서 어휘 표현의 다양성을 조절하였다. Semantic 검증(C)에서는 문장 간 의미적 대비 수준을 단계적으로 조절하여 이에 따른 지표의 반응을 확인하였다.
Flexibility Sub-dimension Validation Results
Sentence 검증에서는 동일 문장의 반복 횟수가 증가할수록 S 지표가 11.75에서 52.76으로 크게 상승하였으며, C 지표 역시 19.03에서 69.89로 증가한 반면, K 지표는 20.00으로 유지되었다. 그러나 반복 패널티가 적용된 유연성 관련 점수는 16.93에서 7.93으로 감소하여, 단순 반복에 따른 세부 지표의 상승이 최종 점수에 그대로 반영되는 것을 억제하였음을 확인하였다.
Lexical 검증에서는 문장 수를 동일하게 유지하고 공통된 주제 범위 내에서 어휘 표현을 다양화하였을 때, S 지표는 31.27로 동일하게 유지되고 C 지표 역시 46.61에서 46.89로 큰 변화가 나타나지 않은 반면, K 지표가 20.00에서 27.07로 증가하였다. 이는 해당 통제 조건에서 K 지표가 어휘 수준의 다양성 변화에 상대적으로 민감하게 반응했음을 보여준다.
Semantic 검증에서는 문장 간 의미적 대비가 증가하도록 조건을 구성하였으나, C 지표는 46.61에서 47.08로 변화 폭이 미미하였다. 반면 의미적 대비가 강한 조건에서 K 지표가 20.00에서 50.34로 증가하였다. 이는 의미적으로 서로 다른 내용을 포함하도록 구성한 문장이라도, 각 문장의 임베딩이 참조 의미 공간에서 서로 다른 클러스터로 충분히 분산되지 않을 경우 클러스터 분포 기반 지표 C의 변화가 제한적일 수 있음을 보여준다. 특히 본 연구의 참조 의미 공간이 이미지 설명 및 만화·웹툰 관련 문장을 기반으로 구축되었다는 점을 고려하면, 본 검증에 사용된 서술형 문장들이 임베딩 공간에서 상대적으로 유사한 서술 영역에 위치하여 클러스터 할당의 차이가 크게 나타나지 않았을 가능성이 있다.
종합하면, S, K, C 지표는 각각 구조적·어휘적·의미적 특성의 변화에 서로 다른 반응 양상을 보였으나, 일부 조건에서는 하나의 입력 특성 변화가 복수의 지표에 함께 반영되는 경우도 확인되었다. 따라서 본 검증은 각 지표가 완전히 독립적으로 작동함을 입증하기보다, 유연성 관련 세부 지표가 통제된 입력 변화에 어떠한 반응 양상을 나타내는지를 확인한 것으로 볼 수 있다.
3. 지속성 지표 검증
지속성은 단순히 동일한 단어나 표현을 반복하는 정도가 아니라, 제한된 의미 범위 내에서 특정 주제에 집중하면서 관련 내용을 구체화하고 확장하는 특성이 프롬프트에 어떻게 나타나는지를 정량적으로 반영하는 지표로 설정하였다. 이를 위해 표현적 구체화(M), 어휘 집중도(D), 의미 범주 집중도(F)의 세부 지표를 종합하여 산출하도록 설계하였다. M 지표는 수식어 사용을 중심으로 프롬프트의 세부 묘사가 구체화되는 정도를 나타내는 관측값이며, D 지표는 입력 내 어휘 사용이 일부 특정 어휘에 집중되는 정도를, F 지표는 입력의 의미적 분포가 특정 의미 범주에 집중되는 정도를 나타낸다.
표 6은 지속성 관련 세부 지표의 반응을 확인하기 위한 통제 실험 결과를 나타낸다.
Persistence Sub-dimension Validation Results
Modifier Usage 검증에서는 수식어를 포함한 세부 묘사 표현의 양을 조절하였다. 수식어가 확장된 조건에서 M 지표가 뚜렷하게 상승하여, 해당 지표가 수식어 사용을 중심으로 한 표현의 구체화 정도에 반응함을 확인하였다.
Density 검증에서는 주제적 연관성을 유지하면서 어휘 사용의 분포를 조절하여, 다양한 어휘를 사용하는 조건과 동일 단어를 반복하는 조건을 비교하였다. 동일 단어 반복 조건에서는 D 지표가 더 높은 수치를 기록하여, 해당 지표가 특정 어휘에 대한 분포의 집중에 반응함을 확인하였다. 다만 세 하위 지표의 반응을 종합한 지속성 관련 점수는 오히려 낮게 산출되었다. 이는 특정 단어나 표현의 단순 반복만으로 지속성 관련 점수가 상승하지 않으며, 어휘적 집중만으로는 종합적인 지속성 관련 특성을 충분히 설명할 수 없음을 보여준다.
Meaning Focus 검증에서는 하나의 주제 또는 제한된 의미 범주에 집중한 입력과 서로 다른 주제로 분산된 입력을 비교하였다. 단일 주제에 집중한 입력에서 F 지표의 값이 더 높게 나타나, 본 통제 조건에서 의미 범주 집중에 따른 F 지표의 반응 방향을 확인하였다. 다만 이 조건에서는 M 지표 역시 0.00에서 48.66으로 함께 증가하였으므로, 지속성 관련 점수의 상승을 F 지표의 독립적인 영향으로 해석할 수는 없다. 따라서 본 결과는 F 지표가 의미적 집중 특성에 반응하는 방향성을 확인한 결과로 제한하여 해석한다.
본 검증은 각 지표의 독립적 기여도를 밝히기보다는, 각 하위 지표가 의도한 입력 특성의 변화에 설계된 방향으로 반응하는지를 확인하는 데 초점을 두었다. 따라서 개별 지표의 변화만으로 지속성 관련 특성을 판단하지 않고 M, D, F의 반응을 종합적으로 해석한다. 특히 M 지표가 반영하는 표현적 구체화는 창의성 연구에서 다루어지는 정교성(elaboration)과 개념적으로 일부 중첩될 수 있다는 점을 함께 고려할 필요가 있다.
4. 창의성 관련 종합 점수 검증
유연성과 지속성을 결합한 창의성 관련 종합 점수가 두 경로의 변화에 따라 어떻게 반영되는지를 확인하기 위해, 두 지표의 조합을 기준으로 4분면 검증을 수행하였다. 각 조건은 유연성 관련 점수와 지속성 관련 점수의 상대적인 수준에 따라 High F/High P(HH), High F/Low P(HL), Low F/High P(LH), Low F/Low P(LL)의 네 조건으로 구분하였다. 표 7은 각 유형별 유연성 관련 점수, 지속성 관련 점수 및 창의성 관련 종합 점수의 산출 결과를 나타낸다.
Creativity-Related Composite Scores by Flexibility-Persistence Combination
유연성과 지속성이 모두 높은 HH 조건에서는 창의성 관련 종합 점수가 52.45로 가장 높게 산출되었으며, 두 지표가 모두 낮은 LL 조건에서는 19.20으로 가장 낮게 산출되었다. 한 경로만 높게 설정한 HL과 LH 조건의 종합 점수는 각각 37.93과 32.81로 중간 수준을 나타냈다.
이러한 결과는 각 조건의 실제 창의성 수준을 검증한 것이 아니라, 유연성과 지속성 관련 점수가 제안된 종합 점수 산출 구조에 따라 반영된 결과이다. 따라서 본 검증은 외부 준거 또는 인간 평가와의 일치도를 검증하기보다, 두 경로의 관련 점수가 종합 점수에 의도한 방향으로 반영되는지를 확인하는 데 목적이 있다.
위 4분면 검증의 종합 점수는 수식 (3)에 따라 유연성과 지속성 두 경로에 각각 0.5의 기본 가중치를 적용하여 산출하였다. 다만 이는 두 경로의 실제 기여도가 동일하거나 해당 가중치가 최적임을 의미하지 않는다. 이에 가중치 설정이 종합 점수에 미치는 영향을 확인하기 위해 민감도 분석을 추가로 수행하였다. 유연성 가중치(wFlex)를 0.3에서 0.7까지 변화시키고, 지속성 가중치(wPers)는 1 - wFlex로 설정하여 각 조건의 종합 점수와 상대적 순위 변화를 비교하였다. 비교 결과는 표 8과 같다.
Sensitivity Analysis of Flexibility and Persistence Weights
분석 결과, 유연성과 지속성 가중치를 0.4:0.6에서 0.7:0.3까지 변화시킨 구간에서는 HH > HL > LH > LL의 상대적 순위가 동일하게 유지되었다. 반면 0.3:0.7에서는 HL과 LH의 순위가 역전되었으며, 두 조건의 상대적 순위가 전환되는 경계는 wFlex ≈ 0.323으로 나타났다. 따라서 기본 설정인 0.5:0.5는 인접한 가중치 변화에서도 기존의 상대적 순위가 유지되는 설정으로 나타났다.
다만 본 민감도 분석은 최적 가중치를 도출하거나 두 경로의 실제 상대적 기여도를 검증하기 위한 것이 아니라, 가중치 변화에 따른 종합 점수와 상대적 순위의 변화를 확인한 결과로 한정하여 해석한다.
Ⅴ. 실제 프롬프트 적용 사례 분석
본 장에서는 실제 생성형 AI 이미지 생성에 사용되는 프롬프트에 제안 시스템을 적용하여, 프롬프트의 수정·확장에 따른 유연성 및 지속성 관련 지표의 반응 결과를 설명한다.
오프라인 단계에서 참조 데이터로 구축한 의미 참조 공간과 온라인 분석 파이프라인을 연계한 API 환경을 구성한 후, 입력 프롬프트에 대해 형태소 분석, 임베딩 및 세부 지표 산출 과정을 수행하였다. 실제 생성형 AI 이미지 생성에 사용되는 프롬프트를 대상으로, 기본 장면 구성은 유지하면서 서술 정보를 확장하고 표현을 구체화하였을 때, 각 지표가 어떠한 변화를 나타내는지 확인하였다. 두 단계의 프롬프트는 모두 동일한 네 개 장면인 숲길, 들판, 도시 및 공원을 소재로 구성하였다.
Phase 1은 각 장면의 핵심 요소를 단순 명사구 형태로 제시하였으며, Phase 2는 동일한 장면을 바탕으로 수식어 표현과 구체적인 묘사가 포함된 완결된 문장 형태로 구성하였다. 따라서 두 조건은 문장 구조, 표현의 구체성, 수식어 사용 및 세부 묘사의 정도에서 차이를 갖도록 구성하였다. 표 9는 실제 생성형 AI를 활용한 이미지 생성에 사용된 프롬프트를 대상으로 분석한 결과를 나타낸다.
Changes in Indicators Following Prompt Description Expansion
Phase 1에서 Phase 2로 표현이 확장됨에 따라 유연성 관련 점수는 50.50에서 59.97로, 지속성 관련 점수는 18.14에서 42.69로 증가하였으며, 두 점수를 결합한 창의성 관련 종합 점수 역시 34.32에서 51.33으로 증가하였다.
본 분석은 여러 표현적 요소가 함께 변화하는 실제 프롬프트 적용 조건에서 제안 지표의 반응을 확인한 단일 사례이다. 특히 Phase 2에서는 서술 정보의 추가와 함께 입력 길이 및 어휘량도 증가하여 복수의 입력 특성이 동시에 변화하였다. 따라서 특정 표현 요소가 각 지표 변화에 미친 독립적인 영향을 분리하여 판단하기 어렵고, 단일 사례에 기반한 점수의 상승을 실제 창의성의 증가나 프롬프트 확장과 창의성 간의 일반적인 관계로 해석할 수는 없다. 본 결과는 동일한 기본 아이디어 구조에서 프롬프트의 표현적 구체화를 포함한 서술 정보의 확장이 지표의 변화에 드러났다는 점에 한정하여 해석한다.
Ⅵ. 결 론
본 연구는 이중 경로 확산적 사고(DPDT) 이론을 생성형 AI의 입력 프롬프트 분석에 적용하여, 프롬프트에 나타나는 창의성 관련 특성을 정량적으로 분석하기 위한 방법론과 시스템을 제안하였다. 기존 DPDT 연구가 주로 인간의 인지 과정이나 창의적 산출물을 대상으로 한 것에 비해, 본 연구는 해당 이론을 생성형 AI 활용 과정에서의 프롬프트 분석에 적용할 수 있는 가능성을 탐색하였다는 점에서 의의를 갖는다.
본 연구의 시스템은 생성형 AI를 활용하는 과정에서 작성·수정된 프롬프트와 그에 따른 지표 변화를 기록하고 비교할 수 있는 기반을 제공한다. 이러한 특성은 향후 생성형 AI 콘텐츠 제작 과정에서 프롬프트에 나타난 인간 창작자의 아이디어 전개와 표현적 개입을 기록·분석하기 위한 보조 도구로 활용될 가능성을 제시한다. 다만 본 연구는 저작권 등록 요건이나 저작물성을 직접 판단하는 법적 기준을 제시하는 것이 아니며, 본 시스템의 점수가 인간 창작자의 창의성 또는 저작권상 기여도를 직접적으로 의미하는 것으로 해석해서는 안 된다. 따라서 본 시스템은 창작 과정에서 나타나는 프롬프트의 특성을 정량적으로 기록하고 비교하기 위한 분석 도구로 이해할 필요가 있다.
한편, 본 연구는 통제된 프롬프트와 제한적인 실제 적용 사례를 중심으로 검증하여 다양한 창작 환경에 대한 외적 타당성이 충분히 확보되지 않았으며, 유연성과 지속성 및 세부 지표에 적용한 동일 가중치의 최적성과 각 지표의 개별 기여도 역시 검증하지 못하였다. 향후 연구에서는 전문가 또는 일반 사용자 평가를 통해 제안 지표와 외부 창의성 평가 간의 관계를 검증하고, 이를 기반으로 각 지표의 상대적 기여도와 가중치 설정을 검토할 필요가 있다.
Acknowledgments
이 논문은 덕성여자대학교의 2025년도 교내연구비 지원을 받아 작성되었습니다.
References
- U.S. Copyright Office, Copyright and Artificial Intelligence, Part 2: Copyrightability, 2025. https://www.copyright.gov/ai/Copyright-and-Artificial-Intelligence-Part-2-Copyrightability-Report.pdf
- J. Baek, Beijing Internet Court Releases Eight Landmark AI-related Cases, Korea Copyright Commission, 2025, https://www.copyright.or.kr/information-materials/trend/the-copyright/view.do?brdctsno=54781, (accessed Jul. 6, 2026).
- Ministry of Culture, Sports and Tourism and Korea Copyright Commission, Guide to Copyright Registration for Generative AI-Assisted Works, Korea Copyright Commission, 2025, https://www.copyright.or.kr/information-materials/publication/research-report/view.do?brdctsno=54253, (accessed Jul. 6, 2026).
- Z. Wang, C. Chen, V. Sehwag, M. Pan, and L. Lyu, “How to Evaluate and Mitigate IP Infringement in Visual Generative AI?,” Proceedings of the 42nd International Conference on Machine Learning (ICML'25), Vancouver, Canada, Vol.267, pp.62555–62574, July 2025. https://proceedings.mlr.press/v267/wang25o.html
-
S. Liu, Z. Shi, L. Lyu, Y. Jin, and B. Faltings, “CopyJudge: Automated Copyright Infringement Identification and Mitigation in Text-to-Image Diffusion Models,” Proceedings of the 33rd ACM International Conference on Multimedia, Dublin, Ireland, pp.11347–11356, 2025.
[https://doi.org/10.1145/3746027.3755027]

- Coalition for Content Provenance and Authenticity (C2PA), C2PA Technical Specification, Version 2.4, 2026. https://c2pa.org/specifications/
- Coalition for Content Provenance and Authenticity (C2PA), C2PA Security Considerations, Version 2.4, 2026. https://spec.c2pa.org/specifications/specifications/2.4/security/Security_Considerations.html
- P. Karimi, K. Grace, M. L. Maher, and N. Davis, “Evaluating Creativity in Computational Co-Creative Systems,” Proceedings of the 9th International Conference on Computational Creativity (ICCC), Salamanca, Spain, pp.104–111, 2018. https://computationalcreativity.net/iccc2018/sites/default/files/papers/ICCC_2018_paper_26.pdf
-
J. Rezwana and M. L. Maher, “Designing Creative AI Partners with COFI: A Framework for Modeling Interaction in Human-AI Co-Creative Systems,” ACM Transactions on Computer-Human Interaction, Vol.30, No.5, Art. No.67, pp.1–28, 2023.
[https://doi.org/10.1145/3519026]
- M. Rhodes, “An Analysis of Creativity,” The Phi Delta Kappan, Vol.42, No.7, pp.305–310, April 1961. https://www.jstor.org/stable/20342603
-
T. M. Amabile, “The Social Psychology of Creativity: A Componential Conceptualization,” Journal of Personality and Social Psychology, Vol.45, No.2, pp.357–376, 1983.
[https://doi.org/10.1037/0022-3514.45.2.357]
-
M. Csikszentmihalyi, “Implications of a Systems Perspective for the Study of Creativity,” in Handbook of Creativity, R. J. Sternberg (Ed.), Cambridge University Press, Cambridge, pp.313–336, 1998.
[https://doi.org/10.1017/CBO9780511807916.018]
-
J. C. Kaufman and R. A. Beghetto, “Beyond Big and Little: The Four C Model of Creativity,” Review of General Psychology, Vol.13, No.1, pp.1–12, March 2009.
[https://doi.org/10.1037/a0013688]
- J. P. Guilford, The Nature of Human Intelligence, McGraw-Hill, New York, 1967.
-
J. A. Olson, J. Nahas, D. Chmoulevitch, S. J. Cropper, and M. E. Webb, “Naming Unrelated Words Predicts Creativity,” Proceedings of the National Academy of Sciences of the United States of America, Vol.118, No.25, e2022340118, June 2021.
[https://doi.org/10.1073/pnas.2022340118]
-
P. Organisciak, S. Acar, D. Dumas, and K. Berthiaume, “Beyond Semantic Distance: Automated Scoring of Divergent Thinking Greatly Improves with Large Language Models,” Thinking Skills and Creativity, Vol.49, 101356, 2023.
[https://doi.org/10.1016/j.tsc.2023.101356]
-
B. A. Nijstad, C. K. W. De Dreu, E. F. Rietzschel, and M. Baas, “The Dual Pathway to Creativity Model: Creative Ideation as a Function of Flexibility and Persistence,” European Review of Social Psychology, Vol.21, No.1, pp.34–77, July 2010.
[https://doi.org/10.1080/10463281003765323]
-
C. L. Taylor and B. Barbot, “Dual Pathways in Creative Writing Processes,” Psychology of Aesthetics, Creativity, and the Arts, Vol.18, No.2, pp.196–208, 2024.
[https://doi.org/10.1037/aca0000415]
-
D. R. Peterson and M. W. Pattie, “Think Outside and Inside the Box: The Role of Dual-Pathway Divergent Thinking in Creative Idea Generation,” Creativity Research Journal, Vol.36, No.2, pp.272–290, 2024.
[https://doi.org/10.1080/10400419.2022.2110738]
-
J. Oppenlaender, “The Creativity of Text-to-Image Generation,” Proceedings of the 25th International Academic Mindtrek Conference (Academic Mindtrek '22), pp.192–202, 2022.
[https://doi.org/10.1145/3569219.3569352]
-
J. Oppenlaender, R. Linder, and J. Silvennoinen, “Prompting AI Art: An Investigation into the Creative Skill of Prompt Engineering,” International Journal of Human-Computer Interaction, Vol.41, No.16, pp.10207–10229, 2025.
[https://doi.org/10.1080/10447318.2024.2431761]
-
M. Torricelli, M. Martino, A. Baronchelli, and L. M. Aiello, “The Role of Interface Design on Prompt-mediated Creativity in Generative AI,” Proceedings of the 16th ACM Web Science Conference (WebSci '24), pp.235–240, 2024.
[https://doi.org/10.1145/3614419.3644000]
- Korean Image Description Dataset, AI-Hub, https://aihub.or.kr/aihubdata/data/view.do?dataSetSn=261, (accessed Jul. 6, 2026).
- Comic and Webtoon Generation Data, AI-Hub, https://aihub.or.kr/aihubdata/data/view.do?dataSetSn=71717, (accessed Jul. 6, 2026).
- hephaex, mecab-ko, GitHub, https://github.com/hephaex/mecab-ko, (accessed Jul. 6, 2026).
- open-korean-text, open-korean-text, GitHub, https://github.com/open-korean-text/open-korean-text, (accessed Jul. 6, 2026).
- SKTBrain, KoBERT, GitHub, https://github.com/sktbrain/kobert, (accessed Jul. 6, 2026).
- 2021년 ~ 현재 : 덕성여자대학교 IT미디어공학전공 학사과정
- ORCID : https://orcid.org/0009-0008-5991-2123
- 주관심분야 : 생성형 AI, 프로시저럴 콘텐츠
- 2021년 ~ 현재 : 덕성여자대학교 IT미디어공학전공 학사과정
- ORCID : https://orcid.org/0009-0006-5895-2479
- 주관심분야 : 생성형 AI, 실감형 콘텐츠
- 2021년 ~ 현재 : 덕성여자대학교 IT미디어공학전공 학사과정
- ORCID : https://orcid.org/0009-0003-6696-1672
- 주관심분야 : 생성형 AI, 웹 서비스 개발
- 2021년 ~ 현재 : 덕성여자대학교 IT미디어공학전공 학사과정
- ORCID : https://orcid.org/0009-0007-0344-0166
- 주관심분야 : 미디어 공학, 소프트웨어 아키텍처
- 1998년 3월 : 큐슈대학교 예술공과대학 정보전달전공 석사
- 2009년 2월 : 중앙대학교 첨단영상대학원 박사
- 2010년 ~ 현재 : 덕성여자대학교 IT미디어공학전공 교수
- ORCID : https://orcid.org/0000-0002-3725-0025
- 주관심분야 : 멀티미디어, 인터랙티브아트, 가상현실, 생성형 AI, AI 저작권